thomeq
#pandas #python
Mam dwie tabele (tab1 - kolumny A, B; tab2- kolumny C, D). Jedna ma 2 wiersz3, druga - trzy. Dla ulatwienia - jedna ma wartosci x, a druga - y.Chce je połączyc wierszami (dokladnie w kolejnosci wystepowania w tabeli), a brakujace wiersze wypelnic np. 'z'.
Pożądany efekt końcowy:
A B C D
x x y y
x x y y
  • Najlepsze
  • Wszystkie komentarze
IamHater
concate mi laczy jakby oddzielnie


@thomeq: bo domyślnie concat łączy po wierszach, zmień parametr axis
IamHater
@thomeq: ciężko mi powiedzieć co tam jeszcze może mieszać, mi zawsze działało tak jak mówi dokumentacja tj.

Combine DataFrame objects horizontally along the x axis by passing in axis=1.
thomeq
Cześć, mam problem - mam dosc duzy plik csv - na tyle duzy, ze samo wczytywanie trwa kilkanascie sekund (a bedzie bardzieł puchł). mocno spowalni mi dzialanie aplikacji - poustawialem juz recznie rodzaje danych w kolumnach, wstawilem gdzuie sie da dane kategoryczne, ale nadal wolno. W zwiazku w tym mam pytaie (jak na razie nic nie znalalem na ten temat w sieci): czy jest opcja wczytywania z pliku csv tylko interesujacyh mnei
  • Najlepsze
  • Wszystkie komentarze
jgruszka93
@thomeq: sqlite + np. peewee a nie jakieś csv ;)
ProfesorBigos
@thomeq: Python ma w standardowej bibliotece dwa proste moduły do tworzenia plików klucz-wartość nazywające się dbm i shelve. Jeśli potrzeba coś do bardziej skomplikowanych operacji, sprawdź pandas i dask.
ehhhh
ehhhh
0
#python #pytanie #pandas

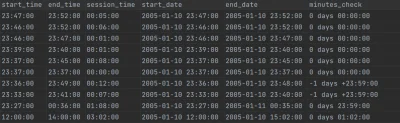
potrzebuję pomocy w sprawdzeniu poprawności danych w skrypcie używającym pandas i datetime w pythonie.

Mam sobie taki input, gdzie start_time, end_time oraz session_time mam podane jako string. Konwertuję to sobie do datetime.timedelta, dodaję start_time do start_date (które na wejściu nie ma podanych godzin i minut, sam rok, miesiąc, dzień), uzyskując start_time jako datetime z godzinami. Następnie dodaję do tego session_time i wychodzi
  • Najlepsze
  • Wszystkie komentarze
ehhhh
ehhhh Autor
1
dobra, poradziłem sobie na stringach, ale dla potomnych: timedelta może przyjąć parametr .abs - https://stackoverflow.com/questions/41782920/how-do-i-format-a-pandas-timedelta-object
CancerLight
@ehhhh porównaj timestampy
thomeq
Cześć,
mam pytania z zakresu #python, #pandas i ogólnie #datascience.
Zasysam dośc duża tabelę z bazy danych (ok 1,5GB). Po zakonczeniu procesu sprawdzam jakiego typu mam kolumny ( tabela.info() ). Wszystkie sa typem 'object'. Jednak jak dam type(tabela[kolumna][0]) to otrzymuje np. decimal.Decimal.
W zwiazku z tym mam pytania:
1. W koncu jakiego typu jest taka kolumna?
2. Z uwagi na dosc duza liczbe wierszy (ok 13 milionow) chce
  • Najlepsze
  • Wszystkie komentarze
leoshelby
@thomeq:
1. https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.dtypes.html
2. Zależy co będziesz chciał robić na tym
3. A po co chcesz to robić? analizować? wrzucać do modelu?
4. Zmierz sobie timeit'em jakąś operację przy ustawieniu string vs. date i zobacz czy ugrasz cokolwiek
leoshelby
2. No to pewnie int będzie lepszy, ewentualnie możesz podzielić sobie dataset tak i w tej części analizy gdzie potrzebujesz tych danych po prostu ich nie wczytywać (tylko trzeba ubić wcześniej kernel/usunąć zmienne z pamięci)
3. To już zależy od tego czego się chcesz dowiedzieć (wiedza domenowa :)) zacznij od df.colum.unique() i zobacz ile masz unikalnych wartości, porób sobie histogramy, boxploty itd i później decyduj, czy jakoś je grupować, zrzucać rzadkie kategorie
tyrytyty
Mam coś takiego, grupujące df po 'name' i wyrzucające sumy dodatnich i ujemnych wartosci z 'xTAdded':

df.groupby(df['name'])['xTAdded'].agg([('neg' , lambda x : x[x < 0].sum()) , ('pos' , lambda x : x[x > 0].sum())])
Jak mogę dodać kolejną kolumnę, gdzie byłaby podobna suma tylko liczona tylko dla kolumn spełniających warunek? Np. chciałbym kolumnę 'buildup', która sumuje dodatnie 'xTAdded' ale tylko, gdy w kolumnie 'endX' jest wartość <70. Tutaj ta lambda się odwołuje sama
  • Najlepsze
  • Wszystkie komentarze
Zendemion
@tyrytyty: chyba chodzi Ci o to? Lambda jako funkcja wartości z dwóch kolumn
rosso_corsa
mam dwa źródła, w każdym źródle jest wachlarz wartości. chciałbym sprawdzić oraz ładnie zwizualizować korelację w #powerbi albo #python #pandas moze być w czymś innym chodzi o to aby jakos ciekawie i najlepiej to zrobić #bazydanych #wizualizacjadanych #naukaprogramowania
  • Najlepsze
  • Wszystkie komentarze
Mr_NiceGuy
Mirki, mam pytanie które wydaje się dość podstawowe ale naprawdę nie mogę nigdzie znaleźć satysfakcjonującej odpowiedzi.

Powiedzmy, że chcę generować dane finansowe dotyczące spółek giełdowych. Ponieważ cena akcji podawana jest codziennie a raporty dotyczące zadłużenia, zysków, czy wartości księgowej rzadziej (na przykład kwartalnie), wydaje mi się że optymalne jest rozdzielenie tych dwóch danych na dwie różne tabele:
- OHLC za każdy dzień
- Snapshot pokazujący dane finansowe z raportu za dany okres
  • Najlepsze
  • Wszystkie komentarze
thomeq
Cześć, mam pytanie z #python, dokladniej z #pandas.
Mam ramke danych z kolumnami: X, Y Q i Z, przy czym Z powstała w wyniku .unique() (tj zawiera w sobie numpy.ndarray z kilkoma wartosciami - wczesniej dla kazdego X i Y bylo kilka roznych wartosci Z, ale zostały ta komenda zebrane do tablicy numpy, tak, ze teraz jedna linijka to jeden unikalny zestaw X i Y) np.
A |
  • Najlepsze
  • Wszystkie komentarze
kamilek98PL
kamilek98PL
  • adult
0
Treść przeznaczona dla osób powyżej 18 roku życia...
  • Najlepsze
  • Wszystkie komentarze
rosso_corsa
szukam prostego sposobu w #pandas #python aby w df zliczyć i wyswietlic a nastepnie usunac wiersze ktore beda mialy 3x nan w trzech wskazanych przeze mnie kolumnach. jest tu moze jakis majster-ekspert ktory mi podopowie? #naukaprogramowania
  • Najlepsze
  • Wszystkie komentarze
login_zajety_sic
login_zajety_sic
Chce zautomatyzować sobie tworzenie makra po przez pythona i zastanwiam się jak to osiągnąć.

Przykładowy case:

Mam plik .xlsx gdzie mam table z kolumnami: kolumna1, kolumna2, kolumna3

chce
  • Najlepsze
  • Wszystkie komentarze
c.....s
c.....s
#python #selenium #pandas

cześć, muszę wykonać kilka operacji na kilkuset obiektach w apce webowej z wykorzystaniem selenium. Kod jest napisany, dane są zaciągane do df z Excela. Moje pytanie dotyczy tego jak "poprawnie i ładnie" to napisać.

Mój pomysł był dosyć prosty i kilka razy go wykorzystywałem, ale czy programista napisałby to w taki sam sposób?

Piszę
  • Najlepsze
  • Wszystkie komentarze
botereq
KoronaScience za darmo: kurs z podstaw Data Science w Pythonie

https://www.facebook.com/events/1094217857617583/

W trakcie kursu:
Poznasz podstawy #python, biblioteki #numpy, #pandas, #matplotlib i innych między innymi napiszemy razem prosty algorytm uczelnia maszynowego. Nauczysz się także pracować z obrazkami
KwasneJablko
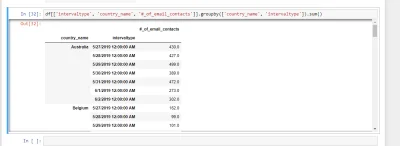
Mam to co na screane. W jaki sposob moglbym zrobic tak aby tabela wygladala w taki sposob:

Intervaltype Australia Belgium Germany France
5/27 100 2000 800 200
5/28 159 777 7993 232
5/29
konik_polanowy
Dzisiaj Mastering Python Data Analysis with Pandas [Video] (Thursday, September 28, 2017)

https://www.packtpub.com/packt/offers/free-learning

#packtpubfreelearning #python #analizadanych #pandas

odpowiedź
  • Najlepsze
  • Wszystkie komentarze
bohater
Mirki, jak to zapisac w #python 2.7 ? Nie ma w nim * do rozpakowywania kolekcji w argumenty :(

correlated = data.corr()['target'][lambda c: c > 0.1]
data = data[[*correlated.index]]

#pandas #numpy #sklearn
  • Najlepsze
  • Wszystkie komentarze
konik_polanowy
  • Najlepsze
  • Wszystkie komentarze
aleteior
aleteior
#python #pandas #inwestycje #polska #ekonomia #programowanie

Zrobiłem interaktywną mapę prezentującą najnowszy wynalazek rządzących, czyli Polską Strefę Inwestycji. Może kogoś zainteresuje. W analizie danych wykorzystałem dwie biblioteki pythonowe czyli xlrd i pandas. A sama mapa zrobiona w QGIS.

Tu link do znaleziska.

https://www.wykop.pl/link/4512601/nie-widac-zaborow-mapa-powiatow-polskiej-strefy-inwestycji/#
Morzan
Znajdzie się ktoś kto ogarnia #pandas, #machinelearning, #scikitlearn i #python? Za cholerę nie mogę wykminić odpowiedniego przygotowania danych do klasyfikacji tekstu. Problem opisałem tutaj: https://stackoverflow.com/questions/49466193/sklearn-text-classification-attributes , jak będzie trzeba mogę to zrobić jeszcze dokładniej.

#programowanie
  • Najlepsze
  • Wszystkie komentarze
erwit
erwit
2
Mirki, mam timeseries z sieci basenow (czas, liczba wejsc, lokalizacja itp..) Chcialbym stworzyc model predykcyjny na podstaiwe tych danych, uzywajac #python #pandas. Przyznaje, ze z metodami stochastycznymi jestem troche na bakier i wlasicie #datascience dopiero zaczynam sie uczyc. Moglby ktos mnie nakierowac jak sie do tego zabrac?

#statystyka #machinelearning
  • Najlepsze
  • Wszystkie komentarze