Treść została ukryta...

- Najlepsze
- Wszystkie komentarze

WpisujcieMiasta
@printHelloWorld: masz nakładki na hadoopa i niewiele to się różni od korzystania w źródle z csv albo z bazy Oracle. My korzystamy z impali kudu sparka. A ludzie co robią jakieś cuda na kiju z pythona albo R
printHelloWorld Autor
@WpisujcieMiasta: Rozumiem że mówiąć 'nakładki' masz na myśli np.: HDFS, MapReduce, YARN, Spark,Pig, Search itp ?
#bigdata #informatyka #hadoop
Witam, szukam szkolenia z Administracji Hadoopa (nie z Cloudery), cena jak by nie gra roli, najlepiej jak w było to szkolenie stacjonarne w Warszawie
Ktoś był i poleca ?
Witam, szukam szkolenia z Administracji Hadoopa (nie z Cloudery), cena jak by nie gra roli, najlepiej jak w było to szkolenie stacjonarne w Warszawie
Ktoś był i poleca ?

Treść została ukryta...
- Najlepsze
- Wszystkie komentarze
@PiotrokeJ: 7k rekordów w sparku? Jebnij im to w sql, pandas albo excelu.
Treść została ukryta...
- Najlepsze
- Wszystkie komentarze
@qbek: taktyk
@qbek: jeżeli chodzi o rozwiązania chmurowe - zazwyczaj kursy od samych dostawców są super

- Najlepsze
- Wszystkie komentarze

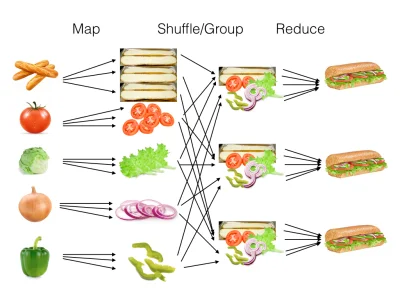
@sztefen_muller: podczas mapowania cebula zmieniła kolor
@rosso_corsa: to nie bug to feature ( ͡° ͜ʖ ͡°)
#bigdata #hadoop #linux
Witam może ktoś z was był szukam jakiegoś szkolenia z Cloudery aby się odbyło do końca tego roku. Czy ktoś może był g w tym roku na takim szkoleniu i poleca lub wie gdzie takie szkolenia się odbywają. Compedium nie ma terminów. Ew. jakie inne szkolenie warto zrobić aby wejść w rozwiązania hadoop jako administrator.
Witam może ktoś z was był szukam jakiegoś szkolenia z Cloudery aby się odbyło do końca tego roku. Czy ktoś może był g w tym roku na takim szkoleniu i poleca lub wie gdzie takie szkolenia się odbywają. Compedium nie ma terminów. Ew. jakie inne szkolenie warto zrobić aby wejść w rozwiązania hadoop jako administrator.
- Najlepsze
- Wszystkie komentarze

@programista4k stawiam że zdecydowana większość utrzymuje go dla hdfsa
Przy okazji yarn ze sparkiem
I hive/impapa
Tam gdzie się da to ida w cloud, więc hadup najprędzej w banku
Przy okazji yarn ze sparkiem
I hive/impapa
Tam gdzie się da to ida w cloud, więc hadup najprędzej w banku
@Kura_Wasylisa: nie ciem do banku :(

#hadoop #informatyka #it #spark #logi #bigdata #analizadanych #logs
Poszukuję mireczki jakiegoś otwartego źródła, na którym mógłbym znaleźć duży zbiór logów z platformy Hadoop. Czy znacie może coś godnego polecenia ?
Poszukuję mireczki jakiegoś otwartego źródła, na którym mógłbym znaleźć duży zbiór logów z platformy Hadoop. Czy znacie może coś godnego polecenia ?

Elo Mirki,
pracuje ktoś jako big data engineer? Łatwo się przekwalifikować z Data Scientista? Mam doświadczenie głównie w developmencie w Sparku, ale raczej Python, ok. 2 lata. W jakich językach piszecie? Dominuje Scala czy raczej Java? Jak wyglądają codzienne zadania?
#hadoop #bigdata #datascience #programowanie
- Najlepsze
- Wszystkie komentarze

Treść została ukryta...
- Najlepsze
- Wszystkie komentarze
Treść została ukryta...
- Najlepsze
- Wszystkie komentarze

Treść została ukryta...
- Najlepsze
- Wszystkie komentarze


Treść została ukryta...
- Najlepsze
- Wszystkie komentarze

Treść została ukryta...
- Najlepsze
- Wszystkie komentarze

Poszukuję tutoriali/ebooków wprowadzających i wyjaśniających Hadoopa i Elastic Search (tak z ciekawości, chcę po prostu to poznać).
Ktoś/coś?
#programowanie #java #it #hadoop #elasticsearch
Ktoś/coś?
#programowanie #java #it #hadoop #elasticsearch
- Najlepsze
- Wszystkie komentarze

#programowanie #hadoop jest cos takiego jak hadoop w przykladach dla poczatkujacych? widzialem ze jest wirtualka, ale to nie jest do konca to o co mi chodzi.
- Najlepsze
- Wszystkie komentarze
Za pomocą MapReduce'a chce przekształcić plik csv (by dało to co pandas.unstack(), zmiana formatu tabeli z "szerokiego" na "wąską i długą"), napisałem prosty mapper i reducer, działa, tylko że wiersze w wyniku są oddzielone pustymi liniami.
Jak można to tak zredukować, żeby otrzymać plik a'la csv, bez pustych linii?
#hadoop #python #programowanie #datascience
Jak można to tak zredukować, żeby otrzymać plik a'la csv, bez pustych linii?
#hadoop #python #programowanie #datascience
- Najlepsze
- Wszystkie komentarze