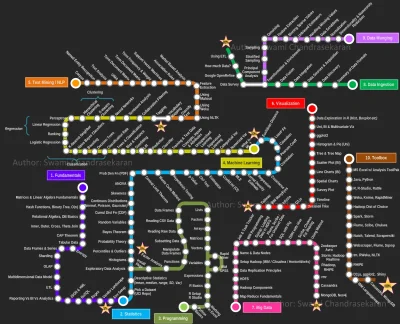
@raffish: Bardzo dobre zestawienie.
Chciałbym zobaczyć takie samo zestawienie Matlab vs R lub Matlab vs Python.
Cały czas na uczelni byłem "otoczony" matlab-em a w praktyce R lub Python lepiej się sprawdzał.
  • Odpowiedz
TED: Wspaniałe i przerażające konsekwencje komputerów, które potrafią się uczyć

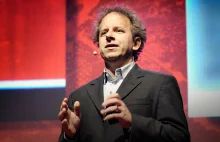
What happens when we teach a computer how to learn? Technologist Jeremy Howard shares some surprising new developments in the fast-moving field of deep learning, a technique that can give computers the ability to learn Chinese, or to recognize objects in photos, or to help think through a medical diagnosis. (One deep learning tool, after watching hours of YouTube, taught itself the
  • 5
  • Odpowiedz
  • Otrzymuj powiadomienia
    o nowych komentarzach

@Hauleth: Tylko że to się dopiero w ostatnim czasie zaczęło tak rozwijać. W takim tempie! Porównując inne cudowne technologie, np. ze świata medycyny, komórki macierzyste i terapie z nimi związane - już istnieją, ale pojedyncze przypadki, zanim to wejdzie do "powszechnego użycia", miną lata.
Tutaj to praktycznie od razu może wejść do powszechnego użycia, te algorytmy są już używane. Oczywiście na wpływ na technologię odczuwalną bezpośrednio dla każdego człowieka trzeba
  • Odpowiedz
Big Data Technology Fundamentals

Big Data Technology Fundamentals provides baseline general knowledge of the technologies used in big data solutions. It covers the development of big data solutions using the Hadoop ecosystem, including MapReduce, HDFS, and the Pig and Hive programming frameworks. This web-based course helps you build a foundation for working with AWS services for big data solutions. This course is offered at no charge, and can be used on its own
  • 2
  • Odpowiedz
  • Otrzymuj powiadomienia
    o nowych komentarzach

Researchers build pattern-recognition model that acts like a human

A trio of MIT researchers has developed a machine learning model that might help humans make better sense of big data by helping us make better sense of the patterns it discovers. Its creators call it the Bayesian Case Model, but a simpler description might be the example-creator.

https://gigaom.com/2014/12/08/researchers-build-pattern-recognition-model-that-acts-like-a-human/

#
  • Odpowiedz
  • Otrzymuj powiadomienia
    o nowych komentarzach

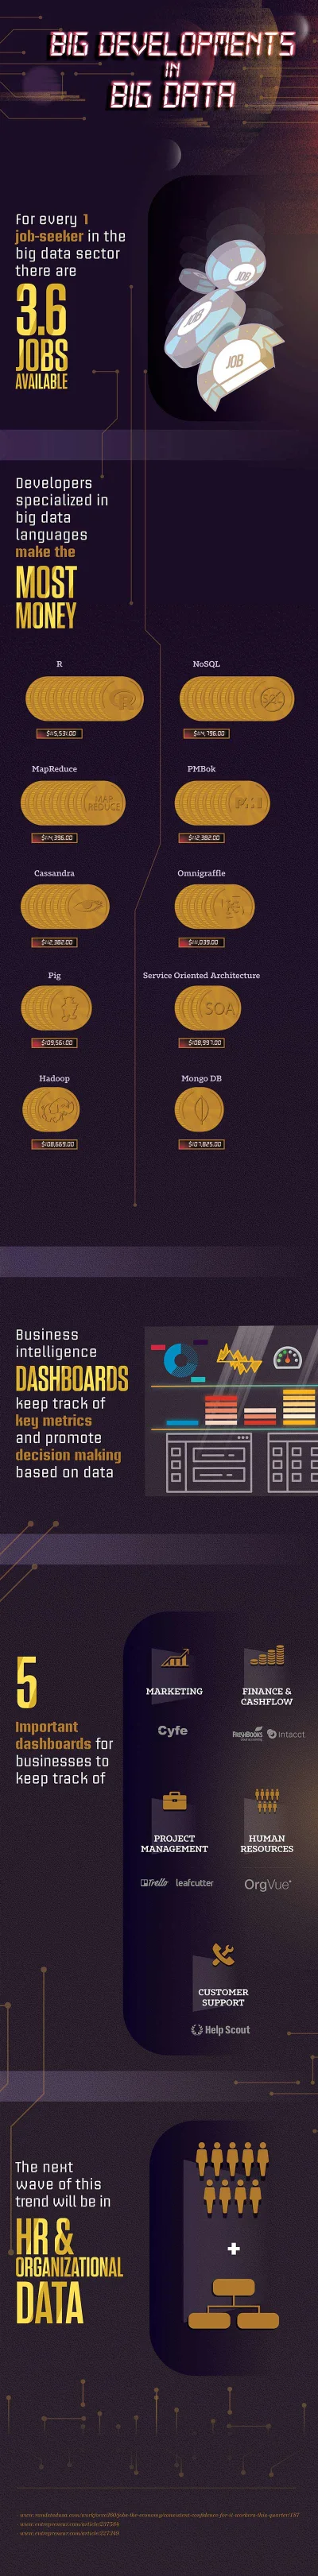
Darmowy ebook na temat zarobkow w sektorze Big Data na rynku amerykanskim.

2014 Data Science Salary Survey

Tools, Trends, What Pays (and What Doesn't) for Data Professionals

[epub,
  • 2
  • Odpowiedz
  • Otrzymuj powiadomienia
    o nowych komentarzach

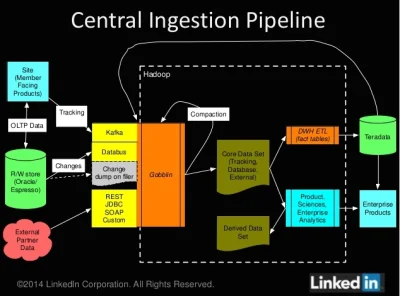
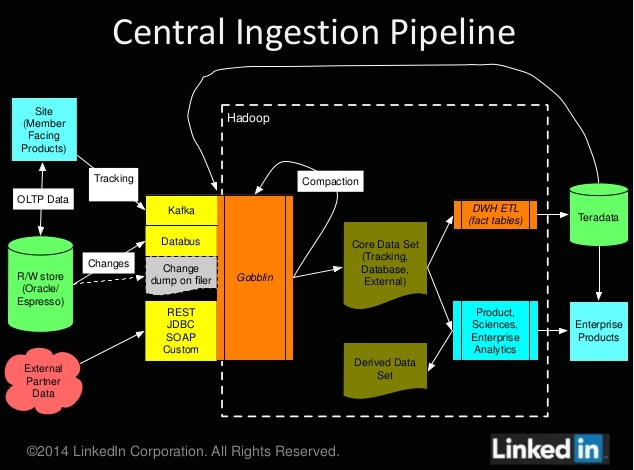
LinkedIn explains its complex Gobblin big data framework

LinkedIn shed more light Tuesday on a big-data framework dubbed Gobblin that helps the social network take in tons of data from a variety of sources so that it can be analyzed in its Hadoop-based data warehouses.

https://gigaom.com/2014/11/26/linkedin-explains-its-complex-gobblin-big-data-framework/

#
m.....q - LinkedIn explains its complex Gobblin big data framework

LinkedIn shed mor...

źródło: comment_EUKIpMU7RRnZIokqO1tGYrITqQteASWL.jpg

Pobierz
  • Odpowiedz
  • Otrzymuj powiadomienia
    o nowych komentarzach

@ri7h: Ważne, że zacząłeś i ruszyłeś w ogóle. Ja się nie mogę zebrać do nauki ciekawych rzeczy, bo albo praca, albo studia, a technologia gna do przodu, a literatura i zabawki czekają.

W każdym razie nie poddawaj się i do przodu!
  • Odpowiedz
@ri7h: Jedna szybka uwaga o poranku - jeśli jednocześnie uczysz się od podstaw dwóch różnych technologii (ew. 2.5 jeśli SAS liczymy jak pół, bo nie zupełnie od podstaw ;-)), a do tego jeszcze robisz kilka różnych kursów na Courserze, to moim zdaniem za bardzo się "miotasz" - to daje pozory tego, że jesteś wydajniejszy niż robiąc jedną rzecz na raz, ale cierpi na tym jakość. Moim zdaniem pracodawcy będą preferować
  • Odpowiedz
@msq:

Hive is Facebook's data warehouse, with 300 petabytes of data in 800,000 tables. Facebook generates 4 new petabyes of data and runs 600,000 queries and 1 million map-reduce jobs per day.


K---a, zaraz chyba zejdę na zawał.
  • Odpowiedz
Mining of Massive Datasets

The book is based on Stanford Computer Science course CS246: Mining Massive Datasets (and CS345A: Data Mining).

The book, like the course, is designed at the undergraduate computer science level with no formal prerequisites. To support deeper explorations, most of the chapters are supplemented with further reading references.

http://mmds.org/
  • Odpowiedz
  • Otrzymuj powiadomienia
    o nowych komentarzach