Fredi_Kamionka_Gmina_Burzenin
#scraping #wykopapi
Jakie wykopowe api ma limity ilości requestów na godzinę?
0
  • Najlepsze
  • Wszystkie komentarze
janusz-lece
0
idzisz
idzisz
Szukam opcji dla pobierania postów z grup FB, których jestem członkiem. Większość scraperów lub usług typu B24 ogranicza się do publicznych grup (co jest zgodne z zasadami FB). Mam konkretne słowa kluczowe, które chcę wyłapywać. Jak się domyślam, FB szybko blokuje próby odświeżania XX grup i pobierania ich postów - stąd może ktoś ma inne sprytne rozwiązanie, jak np. bazowanie na powiadomieniach.

#scraping
0
  • Najlepsze
  • Wszystkie komentarze
throaway
throaway
@idzisz udalo ci sie mirku? Też by mi sie przydało
0
idzisz
idzisz
@throaway: nic niestety, podobno bardzo mocno banują i ciężko to ominąć - ale jeśli masz na celu promocję czegoś to przyznam że obecnie reklamy mety bardzo precyzyjnie trafiają w klientów (w tym grup) i po nastu latach udało mi się trafić w końcu do klientów bez marnowania 95% budżetu. Głównie zasługa podsłuchiwania - ktoś wspomina obok telefonu o materacu i pyk, reklama materacy. Wiadomo, to od dawna trochę tak wyglądało,
0
yjkis
Pytanko, chciałbym pobrać dla 50k domen ich certyfikaty SSL
Dla serwera hostującego to żadne obciążenie 1 request bez strony sam handshake SSL, pytanko tylko czy np ISP może mnie zablokować lub hostingodawca ze uderzam do tak dużej liczby pojedynczych domen?

#isp #sysadmin #sieci #scraping #datascience
0
  • Najlepsze
  • Wszystkie komentarze
biczek
openssl s_client -connect example.com:443 -showcerts < /dev/null | openssl x509 -outform PEM > certificate.pem
2
yjkis
coś w ten deseń właśnie i tak 50k razy :)
1
jannekk
Jest jakiś Mirek, który szuka zlecenia na święta? 😁 Potrzebuję zeedytować wtyczkę od Google Chrome, która szuka lotów lub stworzyć własny scrapper. Więcej info na PW

#python #zlecenie #programowanie #selenium #scraping
0
  • Najlepsze
  • Wszystkie komentarze
odysjestem
@jannekk: Dasz potestować, jak już wyjdzie?
1
zmarnowany_czas
zmarnowany_czas
@jannekk: spróbuj Chatgpt albo Claude. Czasem potrafią stworzyć niezły kod
0
thebigshort
thebigshort
Mam jakieś 1k linków do aukcji konkurencji (docelowo pewnie bym chciał do 10k aukcji) z których chcę pobierać dane do raportu w PowerBI, dokładnie cenę i ilość (albo prosto do PowerBi albo przez skrypt pythona i wtedy do PowerBI).

Nie interesuje mnie moment pobrania tych 1k-10 aukcji, bardziej interesuje mnie kwestia odświeżania danych, czyli ceny oraz ilości.

Czy allegro szybko wyłapują takie ruchy przy takiej ilości? Jakiś sposób na obejście, sprawdzone metody? Czy
0
  • Najlepsze
  • Wszystkie komentarze
fiddle
fiddle
@junus123: Wszystkie strony blokują dużą liczbę zapytań i odpowiadając @thebigshort - tak, do minuty (max kilku, zależy od ilości zapytań) Cię wyłapią i będzie captcha. Oczywiście da się obejść, ale do tego potrzebujesz zainwestować w rotator z przyzwoitą pulą.
1
NieoznaczonaReklama
@fiddle: ja na vpn pobieram skryptem aukcje z kategorii od kiedy zablokowali API i wyłapuję bana z raz na miesiąc i wystarczy zmienić serwer... Także jak czegoś nie robisz i nie masz pojęcia to po co pleciesz głupoty?
1
c.....s
c.....s
#scraping #webscraping #selenium

czy ktoś używał z was serwisów typu zenrows do scrapowania danych? Zazwyczaj radziłem sobie ze zmianą headerów, ewentualnie mniejsze batche, jakieś darmowe proxy. Teraz problem jest taki, że wystarczy otworzyć 5 kart z danej strony i już jest podejrzenie bycia botem :P dlatego rozkminiam nawet takie portale.
0
AnonimoweMirkoWyznania
#anonimowemirkowyznania
Cześć, z góry zaznaczam, że nie mam konta na wykopie i nie mam się kogo poradzić. Od razu podam tagi #programowanie #naukaprogramowania #python #scraping #webscraping

Wymyśliłem sobie taki plan. Zapytacie się jaki? Kurna sprytny.( ͡° ͜ʖ ͡°) Chciałbym scrapować nazwy produktów+ceny tych produktów. Słabo się znam na programowaniu, ale myślę, że ogarnę na podstawie filmików na yt i nauczę
0
  • Najlepsze
  • Wszystkie komentarze
DreqX
Mirki wiecie jak wyciągnąć datę stworzenia ogłoszenia na otomoto? Data pod zdjęciem to oczywiście data odświeżenia, szukałem po requestach ale nie widzę nigdzie.
#otomoto #programowanie #webscraping #scraping
0
  • Najlepsze
  • Wszystkie komentarze
Spofity
Spofity
Jest coś jak #ceneo tylko z API, żebym mógł po nazwie / url produktu znalezc najniższą cene w innych sklepach?

#programowanie #webscraping #scraping #api
0
  • Najlepsze
  • Wszystkie komentarze
pierzchala6
Zna ktoś działający sposób na unikanie wykrycia na Allegro? Używam Selenium w pythonie i selenium-stealth
#scraping #allegro #python
0
  • Najlepsze
  • Wszystkie komentarze
throaway
throaway
Ma ktoś scraper do mieszkań na olx?
#scraping #olx
0
  • Najlepsze
  • Wszystkie komentarze
goferoo
Scrapował może ktoś ostatnio dane ze stooq/money.pl? Potrzebuję danych daily dotyczących wszystkich opcji notowanych na polskiej giełdzie, ale mam problem z sensownym zescrapowaniem tego. Dotychczas leciałem pandasem po bankier.pl i śmigało, na stooq i money już nie ma tak łatwo. Stooq zupełnie nie ładuje się przez request, a money nie przechowuje interesujących mnie danych w htmlowej tabeli, ale w jakichś klasach do których nie mam pojęcia jak się dorwać xD Będę bardzo
0
  • Najlepsze
  • Wszystkie komentarze
Spofity
Spofity
Jakby ktoś potrzebował listę prawie wszystkich procesorów, kart graficznych, płyt głównych to proszę:
https://github.com/Pawikoski/PC-Components

Własnie zescrapowałem i moze sie komus przyda
#procesory: https://github.com/Pawikoski/PC-Components/blob/main/processors.json
#kartygraficzne
3
  • Najlepsze
  • Wszystkie komentarze
kamilm119
Cześć Mirki,

Chciałbym przeprowadzić badanie na podstawie bazy danych na stronie EUvsDisinfo (https://euvsdisinfo.eu/disinformation-cases/). Zastanawiam się, w jaki sposób mógłbym napisać skrypt tak, żeby przy użyciu biblioteki do scrapowanie (np. request) móc pobierać i ładować do beautifulsoup kolejne strony bazy danych. Stron jest od 1 - 1337.

Uprzedzam, że nie mam żadnego wykształcenia programistycznego i znam tylko podstawy podstaw Pythona.

#python #scraping #naukaprogramowania
0
  • Najlepsze
  • Wszystkie komentarze
tyrytyty
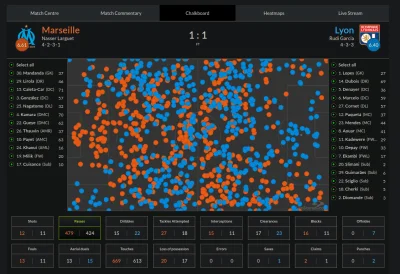
Jak scrapować whoscored.com? Chciałbym pobrać sobie np. listę wszystkich podań i ich współrzędnych z danego meczu (pic related - kropki). Jak się za to zabrać? Dane z innych stron często są łatwo w jsonie lub źródle strony, a tu nie. Wszędzie w internecie czytam że scrapowanie tego jest trudne, a potem widzę jak prawie każdy na tt to robi, ale nie chce ujawniać kodu.

link do przykładowego meczu: https://www.whoscored.com/Matches/1464189/Live/France-Ligue-1-2020-2021-Marseille-Lyon

#python
0
  • Najlepsze
  • Wszystkie komentarze
BidAsk_bet
#python #scraping #ocr

Czy jest możliwe dokładne pobieranie danych z pdfu, który wygląda jak np. gazetka Biedronki?
Potrzebuję zebrać sporo danych historycznych i m.in. takie pdfy są znakomitym źródłem informacji jednak próbowałem różnych programów ocr i efekt jest słaby. Z kolei ręczne wklepywanie kilkuset pdf też wygląda słabo.

Znacie jakieś programy ocr, sposoby jak to zrobić?
0
  • Najlepsze
  • Wszystkie komentarze
4ndy
Czy scrapując filmweb klasyczną metodą python+requests+BeautifulSoup mogę się narazić na bana ip? Jeśli tak, to co zrobić żeby się nie narazić poza ustawieniem delayu w requestach?

#python
#scraping
0
  • Najlepsze
  • Wszystkie komentarze
c.....s
c.....s
Eh :( i znowu coś zmienili na #otodom i znowu kod trzeba dostosować

#scrapy
#python
#scraping
2
  • Najlepsze
  • Wszystkie komentarze
ChamskoCytuje
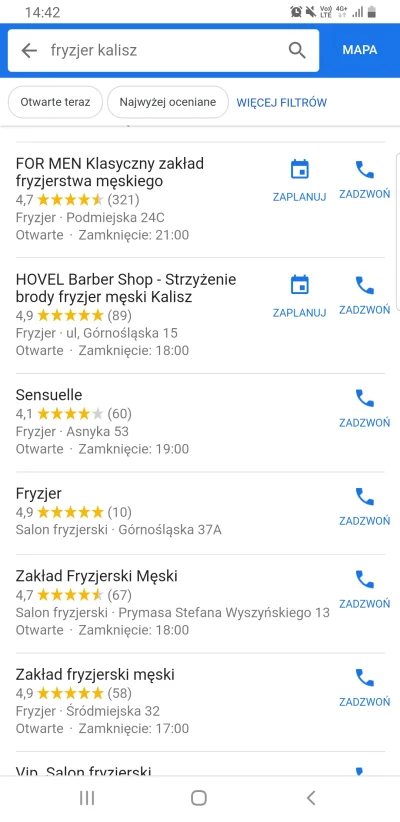
Mirki umiace dobrze w komputer jest sprawa. Chcialbym pobierac z googla informacje na temat fryzjerow. Konkretnie z tej zakladki mapy gdzie sa listy firm dodanyxh do google. Jest jakas inna droga niz scrapowanie? Bo pewnie google sid lrzed tym jakos zabezpiecza.
Wiem ze jest tez cos takiego jak places API, ale platne, a tp tylko hobbystyczny projekt
Najlepeiej jakby byl w C# ale bez znaczenia, chodzi mo o sama idee.
#scraping
0
  • Najlepsze
  • Wszystkie komentarze