LucaJune
Jakie jest best practice jeśli chodzi o tworzeniu notebooków w Azure Synapse Analytics, lepiej wiele małych, czy jeden duży?
Poznaję to dopiero i rozkminiam. Obecnie mam zastany jeden ogromny notebook i kilka średnich i myślę czy tego nie porozdzielać na kilkanaście małych i potem to ładować do pipelinów.

#azure #azuredatafactory #synapseanalytics #azuresynapse #powerbi
  • Najlepsze
  • Wszystkie komentarze
przecietnyczlowiek
przecietnyczlowiek
@LucaJune: tak naprawdę zależy co tam robisz tym notebooku. Ale generalnie chodzi o to, żeby to było w miarę logicznie podzielone. Żeby jasno było widać twój ETL/ELT flow i np. jeden notebook odpowiadał jednemu outputowi docelowemu (np. przetworzonej tabeli) Np. jeżeli masz jeden notebook w którym ładujesz 5 tabelek (wymiarów np.) po kolei no to trochę to jest źle. Lepiej zrobić to odzielnie bo np. wtedy w pipelinach jesteś w
LucaJune
LucaJune Autor
0
@przecietnyczlowiek: dzięki za kompleksową odpowiedź ????
Doceniam, że Ci się chciało. Czyli muszę to porozdzielać. Bo teraz mam tak, że jest jeden giga notebook gdzie tworzone jest kilka tabel.
Jakieś zmiany w nim i debugowanie to katorga.

Jego wykonywanie trwa z godzinę, najdłużej zapisywanie do datalake. To normalne czasy? 4 core tylko dostępne niestety
przecietnyczlowiek
przecietnyczlowiek
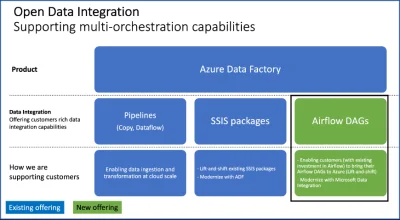
Microsoft chyba zrozumiał, że jego narzędzie do ETL/ELT/orchestration w cloudzie jest takie se i brakuje mu wielu przydatnych usprawnień. Więc po prostu dodał Airflow do niego xD Też fajnie. W sumie po co konkurować z open sourcami, skoro można je zaimplementować i skosić za to kasę od przedsiębiorstw.

https://techcommunity.microsoft.com/t5/azure-data-factory-blog/introducing-managed-airflow-in-azure-data-factory/ba-p/3730151

#apacheairflow #airflow #etl #businessintelligence #azuredatafactory #azure
  • Najlepsze
  • Wszystkie komentarze
peoplearestrange
Treść przeznaczona dla osób powyżej 18 roku życia...
c.....s
c.....s
#azure #adf #dataengineering #cloud #azuredatafactory

Mam pętlę ForEach, w środku której kopiuje dane z jednej bazy do drugiej.
Czy jest jakaś opcja by podejrzeć, która tabela aktualnie się kopiuje?
  • Najlepsze
  • Wszystkie komentarze
c.....s
c.....s
@cohontes: dobra może przyda się potomnym, w pre copy scripcie można dać select na parametr z tableName wtedy w inpucie będzie widziana nazwa tabeli własnie w pre copy scripcie
PiotrokeJ
Dostałem mini task w robocie, powoli zaczynam jako Data Engineer. Muszę wygenerować kilka csv z kilku baz. Proces ma być cykliczny raz w tygodniu może nawet częściej. Jak najlepiej to zrobić? Stworzyć pipeline bazujac na 'Copy Data' activities? Czy pisać wszystko w synapsie/databrick i odpalać cały notebook. Jak coś pomyliłem to sorki, dopiero zaczynam z Data Factory.
#azure #datafactory #bigdata #azuredatafactory #adf
  • Najlepsze
  • Wszystkie komentarze
saviola7
saviola7
@PiotrokeJ: Chyba w ADF prościej wyklikać, Databricksów bym użył do bardziej skomplikowanych operacji na danych. Sam od niedawna w tym grzebie, więc mogę się mylić.