Jako laik zastanawiam się jakie są różnice pomiędzy #selenium a #beautifulsoup. Oba są do tego samego, ale czy któryś jest np. latwiejszy, bardziej rozbudowany itd? Mam zamiar napisać program który będzie monitorował ceny konkretnych produktów w sellgrosie a następnie wysyłał maila pod wskazany adres jeśli cena będzie mniejsza niż x. Z jakiego modułu byście skorzystali i dlaczego? Pozdrawiam #python

- Najlepsze
- Wszystkie komentarze

arysto2011
@kwiato: selenium symuluje przegladarke i wymaga drivera do dzialania. BS to parser HTML.
kwiato Autor
@arysto2011: A czy w selenium rozniez jest wbudowany parser?

#python #beautifulsoup
Próbuję łapać cenę randomowego produktu na amazonie i program działa..., a czasami nie działa. Wywala błąd:
title = soup.find(id='productTitle').gettext()
AttributeError: 'NoneType' object has no attribute
Próbuję łapać cenę randomowego produktu na amazonie i program działa..., a czasami nie działa. Wywala błąd:
title = soup.find(id='productTitle').gettext()
AttributeError: 'NoneType' object has no attribute
- Najlepsze
- Wszystkie komentarze

@boguslaw-de-cubalibre: dodaj sobie obsługę wyjątku, żeby przy wystąpieniu błędu zapisywało treść strony i wtedy będziesz mógł sprawdzić, czy serwer zwraca to, czego oczekujesz

@boguslaw-de-cubalibre: na przyszłość kod w pastebina wrzucaj, będzie czytelniejszy.
Generalnie, błąd wyskakuje przez to, że find() zwraca wartość NoneType, bo nic nie może znaleźć.
Odpaliłem ten kod no i ogólnie to wygląda tak jakby nie każdy request zdążył załadować wszystkie elementy strony. Odpaliłem ten sam skrypt, tylko przerobiłem go tak by źródło strony pobierał przy pomocy Selenium - tytuł i cenę zwraca za każdym wykonaniem pętli.
Z tego co się orientuje, jak strona
Generalnie, błąd wyskakuje przez to, że find() zwraca wartość NoneType, bo nic nie może znaleźć.
Odpaliłem ten kod no i ogólnie to wygląda tak jakby nie każdy request zdążył załadować wszystkie elementy strony. Odpaliłem ten sam skrypt, tylko przerobiłem go tak by źródło strony pobierał przy pomocy Selenium - tytuł i cenę zwraca za każdym wykonaniem pętli.
Z tego co się orientuje, jak strona

#programowanie #python #scraping #beautifulsoup
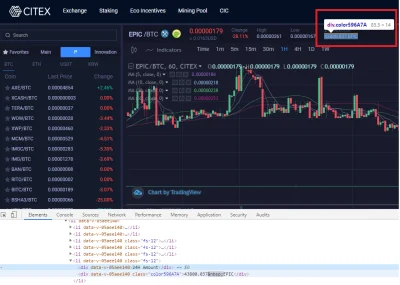
Siemka, jest sprawa - dobiłem do ściany i potrzebuję żeby ktoś wskazał kierunek :/.
SEDNO: oglądam tutoriale i próbuję nauczyć się przy pomocy pythona i bs4/ scrapy zebrać dane z giełdy kryptowalut i za cholerę nie umiem - poradniki zawsze omawiają na bazie stosunkowo prostych stron i z tym nie mam problemu, ale jak przychodzi do real-life zazwyczaj dostaję [ ]...
MORE:
Siemka, jest sprawa - dobiłem do ściany i potrzebuję żeby ktoś wskazał kierunek :/.
SEDNO: oglądam tutoriale i próbuję nauczyć się przy pomocy pythona i bs4/ scrapy zebrać dane z giełdy kryptowalut i za cholerę nie umiem - poradniki zawsze omawiają na bazie stosunkowo prostych stron i z tym nie mam problemu, ale jak przychodzi do real-life zazwyczaj dostaję [ ]...
MORE:
- Najlepsze
- Wszystkie komentarze

@blacktyg3r: używasz selenium? Bo problem pewnie jest przez treść renderowaną w js. Zresztą spójrz lepiej w zakładkę network, wszystkie dane są pobierane requestami z api z tego co widzę.

@blacktyg3r: przeglądarka musi się gdzieś uruchomić i musisz mieć serwer xów albo waylanda. Ale możesz ją schować w trybie headless.
A patrzyłeś czy te giełdy nie mają API? ( ͡° ͜ʖ ͡°)
A patrzyłeś czy te giełdy nie mają API? ( ͡° ͜ʖ ͡°)

Hejka,uczę się pisania web crawlerów i mam problem z #beautifulsoup, a dokładnie z tym by zaciągnąć większą ilość danych gdy są one na stronie pobierane w tle (ajax?) tak jak w przypadku wykopu.
Gdy zaciągam źródło strony ładowane jest 50 pierwszych znalezisk dla danego tagu,więcej ładuje się po zescrollowaniu strony.
Co zrobić żeby załadować więcej znalezisk ? Do pobrania zawartości używam freamworka #requests
krótki kod tego co nabazgrałem: https://pastebin.pl/view/1677c573
bądźcie wyrozumiali,
Gdy zaciągam źródło strony ładowane jest 50 pierwszych znalezisk dla danego tagu,więcej ładuje się po zescrollowaniu strony.
Co zrobić żeby załadować więcej znalezisk ? Do pobrania zawartości używam freamworka #requests
krótki kod tego co nabazgrałem: https://pastebin.pl/view/1677c573
bądźcie wyrozumiali,
- Najlepsze
- Wszystkie komentarze

@malostkowy: moze to cos pomoze? https://blog.michaelyin.info/how-crawl-infinite-scrolling-pages-using-python/

@malostkowy: jeśli to jakiś ajax to możesz użyć selenium. Jeśli tylko adres się zmienia, tak jak na wykopie, czyli wykop.pl/strona/2 to w pętli for podawaj kolejne adresy strony 2/3/4 itd

Potrzebuje pobrać dane ze strony gwp (https://www.gpw.pl/kontrakty_terminowe_pelna_wersja ), interesują mnie wartości z wskaźnikami z tabeli class="tab03 tabFloatingHeader"
gdy próbuje się pobrać przez:
gdy próbuje się pobrać przez:
r = requests.get(url)
soup = BeautifulSoup(r.content,- Najlepsze
- Wszystkie komentarze

@seelk: Tu są: https://www.gpw.pl/ajaxindex.php?action=GPWQuotations&start=showDerivativesTable&tab=ipk_indeksy&type=K⟨=PL⌖pagecard=&defaultorder=cval&full=1

Robię prosty scrapper, który wyciąga linki ze stron www. Natknąłem się na 2 strony, których budowa jest dosyć nietypowa przez co nie mogę dobrać się do linków. Te strony to:
http://www.wp.pl/ - nie ma w swojej strukturze żadnych linków - widać to w źródle strony.
http://docs.celeryproject.org/ - przekierowuje do http://docs.celeryproject.org/en/latest/ co jest rozsądne ale jak zrobić uniwersalną regułę, która będzie przygotowana na takie sytuacje? Jak pobrać docelowy adres?
Czy
http://www.wp.pl/ - nie ma w swojej strukturze żadnych linków - widać to w źródle strony.
http://docs.celeryproject.org/ - przekierowuje do http://docs.celeryproject.org/en/latest/ co jest rozsądne ale jak zrobić uniwersalną regułę, która będzie przygotowana na takie sytuacje? Jak pobrać docelowy adres?
Czy
- Najlepsze
- Wszystkie komentarze